第二盏灯 · 进行中 最后核对:
kanhe
拿瑞士联邦公投手册查证说法的工具。它判断手册是支持、矛盾还是没法下结论,并摘出依据的手册原句。
说法 · 德语
Der Bundesrat rät der Bevölkerung, die e-ID abzulehnen.
联邦委员会建议民众否决 e-ID。
手册 · 法语 · 2025 年 9 月 28 日的投票 · 第 31 页
Pour toutes ces raisons, le Conseil fédéral et le Parlement vous recommandent d’accepter la loi sur l’e-ID.
出于以上理由,联邦委员会和议会建议您投票接受 e-ID 法。
kanhe · 矛盾 · 引文在手册里逐字找到了
- 对象
- 瑞士联邦公投手册,德、法、意三种语言
- 模型
- swiss-ai/Apertus-v1.5-8B,负责翻译和判断
- 检索
- BM25,挑出给模型读的段落
- 缘起
- Hack Apertus Online · Track 2A · OST 挑战:瑞士官方公投手册上的多语言自然语言推理
- 进度
- 还在做。2026 年 10 月 16 日中午 12 点(欧洲中部夏令时)截止提交,还没评审。
- 谁做的
- Hongyu Zhou 一个人做的
- 许可
- 代码 Apache-2.0 · 报告和文档 CC-BY-4.0 · 缓存的模型回答 CDLA-Permissive-2.0 · 评测集 MIT(OST)· 手册是瑞士联邦办公厅的官方出版物
- 链接
- 暂时没有,代码仓库还没公开。
- 最后核对
它做什么
给 kanhe 一句说法和一份瑞士联邦公投手册,两者可以是德、法、意里的任意一种语言,它回答手册对这句话是支持、矛盾还是没法下结论。自然语言推理里,这三种结论叫蕴含、矛盾和中立。
如果给的是整本手册 PDF(任务 A),它只读讲这次投票的那几页;说法和手册语言不同,就先翻译说法;接着让 BM25 挑出最相关的八段,再由 Apertus-v1.5-8B 给出结论和依据的句子。如果给的是一篇文字(任务 B),模型读其中最相关的三段,外加开头第一段。
它引用的每一句,都会逐字检查是不是真在手册里,任务 A 的引文还标出 PDF 页码。
数字
| 任务 | 输入 | Macro-F1 [95% 置信区间] | 每句说法的 token | 每句说法的延迟 |
|---|---|---|---|---|
| A | 说法、手册 PDF、投票名称 | 0.913 [0.885, 0.941] | 1272 | 0.91 s |
| B | 说法、一篇文字 | 0.967 [0.946, 0.983] | 923 | 0.85 s |
在 70 条开发数据上,直接把整本 PDF 交给模型,得分 0.538,每句说法要 42495 个 token。同样的数据,kanhe 得 0.864,token 只用了 3%。
出处 · kanhe README,任务 A,开发数据
任务 B 里,kanhe 和直接把整篇文字交给模型的做法在统计上打平:0.967 对 0.973,配对差 −0.006 [−0.021, +0.007],token 只用了 42%。
出处 · kanhe README,测试集
拆解图
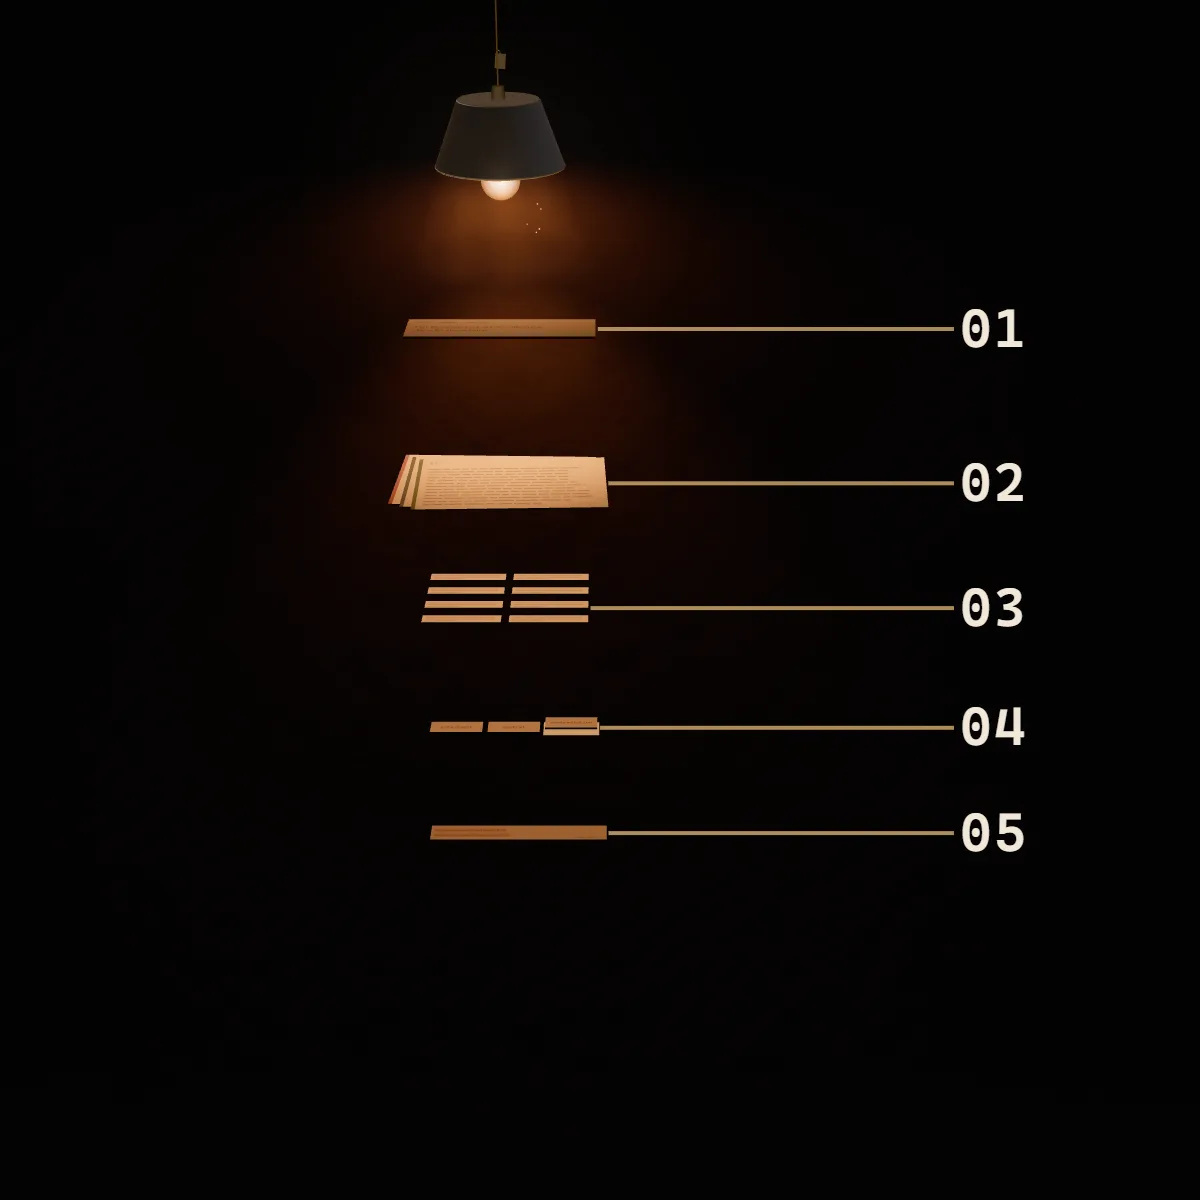
- 01 说法:评测集第 1021 条,德语
- 02 手册:德、法、意三种语言
- 03 BM25 挑给模型读的八段
- 04 结论:支持、矛盾或没法下结论
- 05 引文:回手册逐字比对,并标上页码
为这个网站画的示意图,说明 kanhe 由哪几部分组成,不是截图。
零件清单
已经有了
- 两个比赛任务都按主办方的评测要求提交:Docker,linux/amd64,不用 GPU
- 每句引文都逐字比对;任务 A 的引文标出 PDF 页码
- 六个示例可以用 make demo 从缓存直接重放,不用 API 密钥
- 技术报告里的每张表都可以用 make run 从缓存的回答重新算出来
还没有
- 公开的代码仓库
- 正式的评审结果
可以挑刺的地方
- 不是每个回答都带着比对通过的引文:判为支持或矛盾的回答里,任务 A 有 90% 带了,任务 B 有 96%。
- 任务 A 里最弱的一组,是德语说法配德语手册:37 条,macro-F1 只有 0.789。
- 任务 A 的 331 个模型回答里,有 4 个解析不出来。
- 技术报告里有按语言拆开的得分、两个完全不读手册的对照基线,也写了局限。
幕后
kanhe 是为 Hack Apertus Online 的 Track 2A 做的。所有配置都在 2020 到 2024 年的手册上定好,再拿 2025 和 2026 年的手册,每个任务只跑一次。模型的回答全都缓存下来了,所以六个示例能用 make demo 重放,报告里每张表能用 make run 重新算出来,既不用 API 密钥,也不用 GPU。评测集是 OSTswiss/MNLIoverSwissVotingBooklets,MIT 许可。